Конвейер обработки текстовых данных: разбор, проверка, преобразование
Разбор, проверка и преобразование текстовых данных в трёх отдельных стадиях: что каждая стадия делает, как сохранять промежуточные результаты и почему порядок этапов остаётся проектным решением.
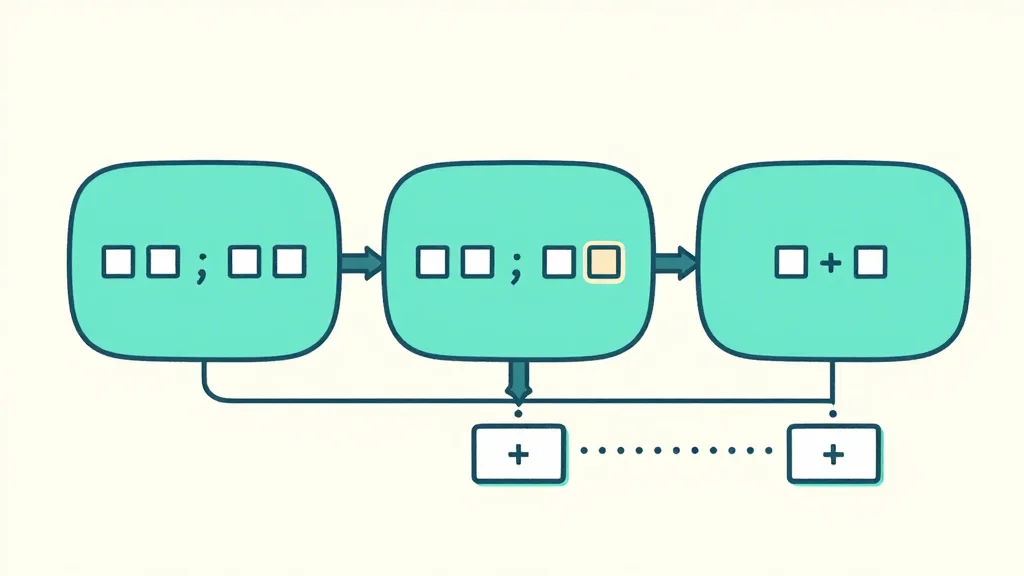
Назначение
Конвейер обработки текстовых данных разделяет работу над входной строкой на стадии с разными обязанностями: разбор, проверка и преобразование. Такая разбивка упрощает диагностику, потому что ошибка фиксируется на конкретном этапе, а не растворяется в едином блоке кода. Читатель получает схему, которую можно применить к собственным данным, не полагаясь на детали чужой реализации.
Представление данных
Для примера используется намеренно ограниченная иллюстративная строка: 12;15. Разделитель полей — точка с запятой, формат не допускает кавычек, экранированных символов и переносов внутри полей. Это не CSV в полном смысле: реальный CSV требует грамматики, учитывающей цитаты и многострочные значения. Здесь же достаточно простого разделения строки по разделителю и перевода каждого поля в целое число.
Стадия разбора
Разбор отвечает на структурные вопросы: сколько полей содержит строка, какие разделители встречаются, можно ли прочитать каждое поле как число заданного синтаксиса. Для строки 12;15 результат разбора — два поля со значениями 12 и 15. Если в строке окажется три разделителя или поле «abc», разбор фиксирует структурную ошибку и передаёт её дальше вместе с исходным текстом. Отдельно проверяется синтаксис чисел: объявляется, что принимаются целые значения без десятичной части и без знаков.
Стадия проверки
Проверка работает уже с разобранными значениями и проверяет правила предметной области. Например, можно потребовать, чтобы каждое поле было неотрицательным и не превышало заранее объявленный предел. Значение 12;15 проходит проверку. Строка с полем «-3» будет отклонена не потому, что её нельзя разобрать, а потому, что она нарушает объявленное правило. Важно не смешивать эти два типа ошибок: структурная ошибка означает, что строка не соответствует формату, а ошибка проверки означает, что формат соблюдён, но значение недопустимо.
Стадия преобразования
Преобразование меняет данные при сохранении или изменении их количества. Нормализация каждого поля и сортировка строк сохраняют число записей: из одной строки получается одна строка. Фильтрация, агрегирование и объединение таблиц могут уменьшать или увеличивать количество записей. В иллюстративном конвейере преобразование ограничено суммированием полей: 12 плюс 15 даёт 27, и результат записывается в выходную строку. Это осознанный выбор, а не универсальное свойство любой стадии преобразования.
Промежуточные результаты
Каждая стадия сохраняет достаточно информации для диагностики. Если строка отклонена на проверке, в журнале остаются исходный текст, результат разбора и номер нарушенного правила. Это позволяет отличить опечатку в синтаксисе от допустимого формата с недопустимым значением. Без таких промежуточных данных поиск причины отказа превращается в перебор вариантов.
Ограничения и проектные решения
Порядок стадий и политика обработки отклонённых записей — проектные решения, а не универсальные гарантии. В этом примере отклонённые строки не проходят преобразование. Другой конвейер мог бы попытаться исправить запись и повторно проверить её по явному правилу восстановления. Аналогично, отсутствие поля нельзя молча заменять нулём: это допустимо только при объявленной политике обработки пропусков. Единицы измерения и версия формата входят в контракт входных данных и должны быть зафиксированы до запуска конвейера.